Codeberg, GitHub, y el patrón que se repite en todo el software libre
Codeberg le cierra la puerta a los LLMs mientras GitHub apuesta todo por ellos. La diferencia no es filosófica: es quién paga las cuentas, y ese patrón se repite en todo el software libre.
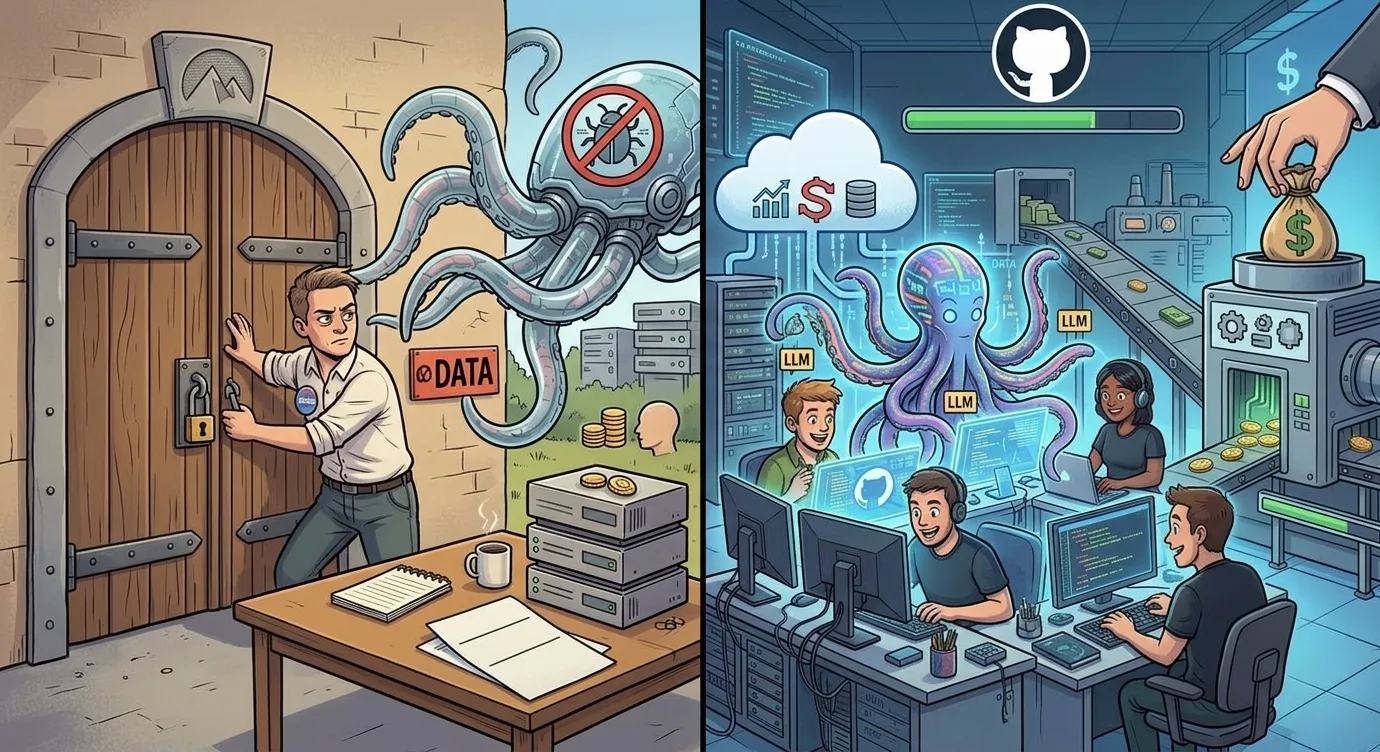
Andaba leyendo un post en el blog de Codeberg sobre su postura frente a los LLMs, y algo me llamó la atención de inmediato: sus políticas son prácticamente lo opuesto a las de GitHub. Mientras GitHub le apuesta todas sus fichas a la IA —Copilot metido en cada rincón del producto, agentes autónomos como característica central—, Codeberg está haciendo justo lo contrario: modificando sus Términos de Uso para cerrarle la puerta a proyectos “vibe-coded” y negándose, como asociación, a usar el código o los datos de sus usuarios para entrenar modelos.
Y no es solo postura filosófica. Los motivos que da Codeberg son bastante concretos: los crawlers de empresas de IA les generan carga pesada en sus servidores —ignoran el git clone de toda la vida y en su lugar rastrean cada variante de filtro de issues, cada punto del historial de Git, línea por línea—, lo que les cuesta trabajo real de administración de sistemas. También hablan de la inflación de hardware provocada por la demanda de IA: mencionan un tipo de disco que hace algunos años les costaba 700 euros, y que ahora cuesta más de 3,700 —cuando hay stock. Y quizás el argumento que más se me quedó grabado: la erosión de confianza dentro de la propia comunidad, con maintainers saturados revisando contribuciones de bajo esfuerzo generadas por IA, y gente acusándose mutuamente de usar LLMs sin ninguna prueba real.
GitHub, mientras tanto, va exactamente para el otro lado.
Aquí es donde la cosa se pone interesante, porque ninguno de los dos está optimizando por y para lo mismo. GitHub es de Microsoft, y como cualquier producto corporativo, optimiza por crecimiento, por retención, para justificar la lanota que ya se gastaron en IA. Codeberg es una asociación sin fines de lucro, sostenida por donaciones, y optimiza por sobrevivir con recursos limitados mientras protege una cultura de colaboración que dependía de que el código compartido tuviera, literalmente, alguien detrás manteniéndolo.
Y ahí está el patrón que se repite una y otra vez en el software libre: en el fondo, casi siempre hay dos escenarios posibles detrás de cada proyecto. Uno respaldado por una corporación con intereses comerciales propios. Otro sostenido por una comunidad, con donaciones, con voluntarios, y con recursos que nunca alcanzan del todo o para nada.
Y no es la primera vez que vemos esta división, segutamente tampoco va a ser la última. La vimos con Terraform, cuando HashiCorp cambió su licencia a algo menos permisivo y la comunidad respondió bifurcando el proyecto en OpenTofu, ahora bajo la Linux Foundation. Pasó con Elasticsearch y con MongoDB, relicenciando para protegerse de que AWS se llevara el negocio de ofrecer sus propias bases de datos como servicio sin regresarle nada al proyecto original. La vimos, más recientemente, en el pleito entre Automattic y WP Engine alrededor de WordPress, donde quedó clarísimo que la frase “de código abierto” no siempre significa “gobernado de forma neutral”. Y la seguimos viendo cada vez que una herramienta gratuita y comunitaria empieza a ganar hype, y aparece una versión “empresarial” del mismo concepto, con mejor financiamiento y objetivos distintos.
Lo de la erosión de confianza que menciona Codeberg no es ajeno para mí. Storytime, sirvanse palomitas, un refresco y escuchen al viejo McDonald: Hace años hacía fansub —era mi forma de contribuir a la comunidad otaku/anime—, y hoy en día, entre la chamba, la familia, la chamba, otras ocupaciones y la chamba, ya no tengo tiempo para eso. Pero hace poco me di el tiempo de contribuir de otra forma: reportar y corregir un par de issues que encontré en el repositorio de Aegisub, el programa que usaba para hacer los subtítulos. Nada grande —una de las correcciones simplemente evitaba que una ventana de búsqueda se cerrara sola cuando no encontraba resultados.
El problema no estuvo en el código. Estuvo en el code review. Obviamente y cómo ya sabrán o habrán notado el inglés no es mi idioma natal, y aunque me puedo expresar en él sin problema, muchas veces es más rápido pedirle a una IA que me ayude a traducir mis ideas antes de escribir el comentario. Uno de los mantenedores del proyecto notó algo en cómo estaba redactado uno de mis comentarios, y me pidió que respondiera los hilos yo mismo en lugar de dejar que un agente lo hiciera por mí, dando a entender que no le interesaba leer una descripción “inventada” por una IA sobre cómo funcionaba algo.
Ese comentario, sin más pruebas que la sospecha, bastó para que mi código dejara de considerarse. El PR sigue abierto y abandonado hasta la fecha.
No cuento esto para quejarme del mantenedor —entiendo perfectamente la fatiga de revisar código con la sospecha constante de que del otro lado hay un LLM disfrazado de colaborador. Pero es exactamente el tipo de daño colateral que describe Codeberg: cuando la desconfianza se vuelve la norma, hasta las contribuciones genuinas terminan pagando el precio de las que no lo son.
Lo que hace que este patrón valga la pena de discutir no es que uno de los dos bandos sea el “malo”. GitHub no está actuando de forma irracional al apostarle a la IA —es exactamente lo que se espera de un producto que necesita justificar miles de millones de dólares en inversión frente a sus evil overlor… digo, accionistas. Y Codeberg tampoco está siendo ingenuo al rechazarla —está protegiendo lo único que realmente tiene: una comunidad que confía en que el trabajo que comparten ahí va a seguir teniendo dueño, mantenimiento, y sentido.
El problema es que el código en sí mismo no tiene bandera. Un repositorio en GitHub y uno en Codeberg pueden tener exactamente la misma licencia MIT, el mismo README, el mismo propósito técnico. Pero las reglas del lugar donde vive —quién decide qué se permite, quién paga el servidor donde corre, quién se beneficia si algún día se vuelve valioso— nunca son neutrales, aunque el código lo sea. Y esas reglas casi siempre terminan reflejando de dónde sale el dinero que sostiene la plataforma.
Como alguien que mantiene un par de proyectos propios, ninguno con nada remotamente parecido a un modelo de negocio detrás (aún), entiendo perfectamente la postura de Codeberg: cuando no hay un plan de monetización esperando al final del camino, lo único que te queda es proteger la razón por la que empezaste el proyecto en primer lugar. Y esa razón casi nunca es “que un LLM entrene con mi código sin que yo lo sepa ni lo autorice”.